本地 AI 的數據治理:在 2026 年保持你的資料集合規且安全
下一個前沿:從模型治理到數據治理
隨著針對2026年關鍵法規的基礎 AI 治理框架已經到位,一個更細緻的挑戰也隨之而來:確保為你的模型提供動力的資料。你本地部署的大型語言模型(LLM)可靠性、倫理性和合規性,都取決於它們微調所用的資料或檢索的文件。在 2026 年,隨著全球資料保護和 AI 規範同步成熟,主動的資料治理將不再只是 IT 後端的工作,而會成為 AI 基礎設施中至關重要的戰略層。這篇文章超越模型部署,提供了一個實用藍圖,確保你的數據集管理得和最敏感的業務資產一樣嚴謹、安全、合規,讓你的本地 AI 環境不只是技術專案,而是成為可信賴的系統。
2026 年的監管環境:為什麼「本地」已不再等於「無規管」
一開始選擇本地 AI 可以提供明確的界線:你的數據會留在你的物理或網路範圍內。不過,像是歐盟的 AI 法案和 GDPR,以及北美和亞洲不斷演變的標準,現在會對數據及其使用方式施加規範,而不只是關注數據的位置。重點的改變是,從單純擁有數據,轉變為在你的 AI 系統中負責任地管理整個數據生命周期。
2026 年 AI 資料的核心監管壓力點:
- 來源與合法性:你必須記錄訓練或微調資料的來源,並證明你有合法權利(例如,授權、同意)將其用於 AI 目的。「公開可得」並不自動等於「隨便用」哦。
- 偏見與公平性緩解:高風險的 AI 系統需要積極採取措施來識別和減少訓練數據集中的偏見。這需要有文件化的流程來處理數據選擇、清理和偏見評估。
- 以隱私為設計(PbD)& 資料最小化:像 GDPR 的原則現在已明確納入 AI 規範。你必須在 AI 系統中最小化使用個人資料,並且預設實施技術防護措施(例如假名化)。
- 在上下文中的資料安全性:提交給你在生產環境中使用的語言模型(LLM)的文件、聊天或查詢,也就是它的「上下文資料」,需要和你的核心資料庫一樣的安全性和存取控制。
- 解釋與刪除的權利:個人可能有權了解他們的數據如何影響 AI 的決策,並要求刪除這些數據,這需要精確的數據來源追蹤。
地方 AI 數據治理的三大支柱框架
有效的治理建立在三個相互關聯的支柱上:政策、流程和平台。這個框架確保原則被明確規範、持續執行,並透過技術來強化。
支柱1:政策–行車規則
建立明確的書面標準,讓 AI/數據生命周期中的每個人都必須遵守。
- 資料分類架構:一個簡單的分類法(例如,公開、內部、機密、受限),適用於所有資料集,規範它們在 AI 中的使用方式。舉例來說:包含個人識別資訊的「受限」資料,若沒有明確的書面同意和隱私設計(PbD)控制,就不能用來進行模型微調。
- AI 資料可接受使用政策:你一般資料政策的特定延伸,定義了允許的來源(核准的供應商、內部資料庫)、禁止的使用方式(例如,未經法律審查不得用於臉部辨識訓練),以及資料標註和文件化的要求。
支柱2:流程-運作引擎
有記錄的、可重複的流程把政策變成行動。
- 資料來源與血統追蹤:一個必須的流程,用來記錄資料集的來源、轉換過程,以及在特定模型版本中的使用情況。可以把它想像成 AI 模型的營養標示。
- 微調前數據評估:在使用任何數據集進行訓練前,進行清單驅動的檢查。應包括權利驗證、偏差篩查(使用統計工具)、隱私審查(個人識別資訊檢測),以及準確性和完整性的質量檢查。
- 資料外洩事件應對:針對潛在的 AI 資料事件的特定流程,例如模型輸出中意外洩露個人識別資訊(PII),或未經授權存取訓練資料集。
支柱3:平台 – 技術執行者
能自動化並大規模執行治理的技術,已整合到你本地的 AI 系統中。
- 統一的元資料與目錄層:一個中央系統(例如 OpenMetadata、Amundsen),作為所有資料集的「單一真實來源」,用來追蹤它們的分類、血統和擁有者。
- 自動化資料品質與隱私掃描器:能自動在資料管線上運行的工具,用來檢測個人識別資訊(PII)、標註品質問題,或標記潛在的偏差指標(例如,人口分布不均)。
- 安全、受管理的資料工作空間:專門的、受存取控制的環境(像是隔離的 Docker 容器或 Proxmox 虛擬機),資料科學家可以在這裡使用已批准的資料集,但無法進行未經授權的複製或匯出。
實作框架:技術深度探討
這裡介紹如何將這些支柱轉化為你本地 AI 架構中的具體行動,同時利用並擴展本系列前幾篇文章中的基礎設施。
- 保障資料集全生命週期:從導入到歸檔
每個資料集都應該通過受管理的流程處理。
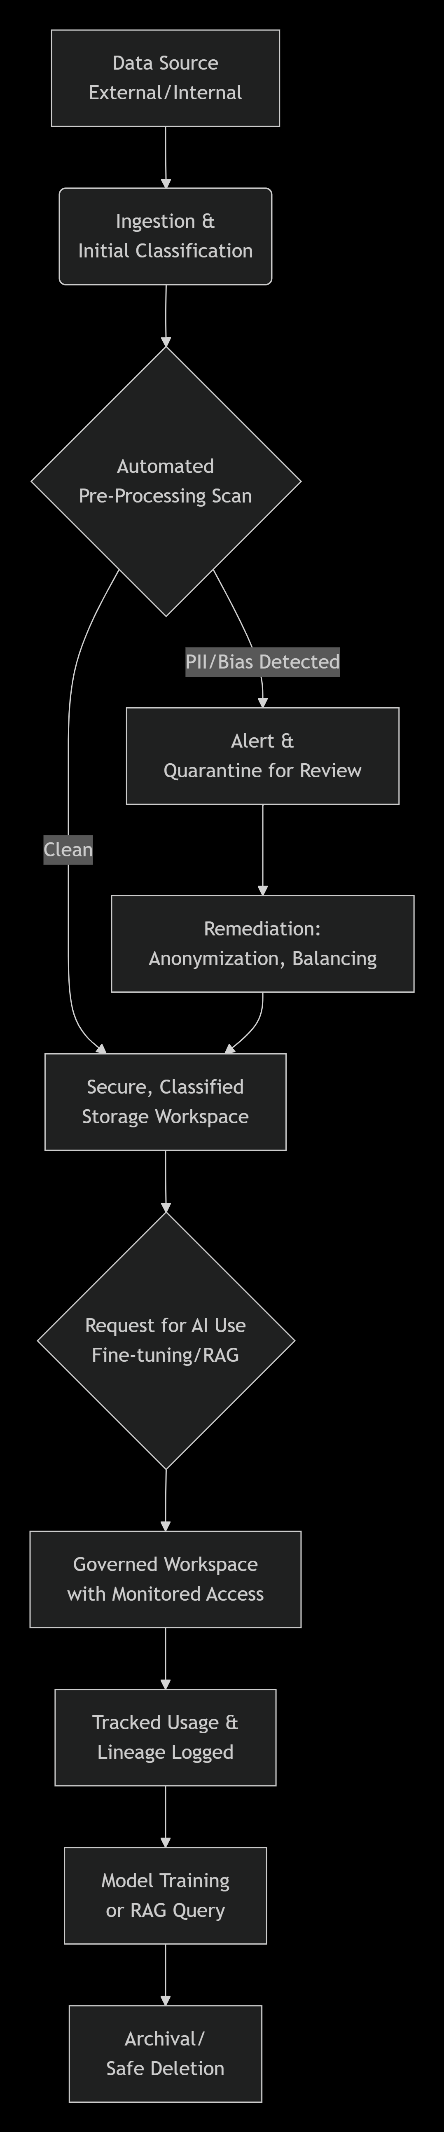
主要工具與指令:
- 在資料進入時檢測個人可識別資訊(PII):在你的資料管線中直接使用像 Microsoft Presidio 或 greyn 這類的工具。
| # Example using a CLI scanner to check a dataset
python -m presidio_analyzer –text “Sample dataset content with email john@example.com” –all_fields |
- 血統追蹤:使用開源的 OpenLineage 標準搭配你的資料處理工具,自動捕捉血統事件並推送到你的元資料目錄中。
- 用於 AI 工作負載的隱私增強技術(PETs)
使用在資料使用過程中保護資料的技術,超越基本存取控制。
- 合成數據生成:在測試或原型模型時,可以使用像 Synthetic Data Vault (SDV) 這樣的工具來創建逼真但人工的數據集,既保留統計模式,又不洩露真實個人資訊。
- 即時偽名化:實作一個服務,在文件送到 RAG 檢索或微調流程之前,動態地把真實識別資訊(姓名、ID)替換成代幣,只有授權使用者在查看最終輸出時才會還原這個過程。
- 建立一個合規的檢索增強生成(RAG)流程
RAG 系統會從內部文件庫中提取資料,這帶來了獨特的治理挑戰。
- 來源來源說明:你的 RAG 系統必須設定好,以記錄每個生成答案所使用的確切來源文件。這對於審核和核實準確性非常重要。
- 區塊級存取控制:在向量資料庫實作權限,讓查詢只能取得使用者有權查看的文件區塊,避免不同部門之間的資料外洩。
你的 2026 資料治理準備清單
使用這個可操作的清單來評估並提升你的能力。
| 治理範圍 | 自我評估的關鍵問題 | 合規行動步驟 |
| 來源與權利 | 我們能為我們 AI 訓練中使用的每個資料集產生法律依據嗎? | 建立一個資料來源登記表(簡單的試算表或整合目錄),記錄來源、授權和合法依據。 |
| 從設計開始注重隱私 | 我們的 AI 資料集裡的個人資料是不是預設就已經被最小化和保護了? | 在所有資料準備流程中實作自動化個人識別資訊掃描,並為專案建立隱私保護技術選擇指南。 |
| 偏見與公平 | 我們有沒有方法可以偵測我們訓練資料中可能的偏差? | 採用偏見評估工具包(例如 IBM AI 公平性 360、Google 的 What-If 工具),並要求在訓練前審查中使用它。 |
| 安全與存取 | 對 AI 數據集的存取控制有像我們核心金融系統那麼嚴格嗎? | 在所有資料存儲上執行基於角色的存取控制(RBAC),並為數據科學實施受監控的獨立工作空間。 |
| 透明度與來源 | 我們能追蹤到是哪個數據集版本用來創建特定的模型行為嗎? | 部署一個元數據目錄,並要求在所有模型訓練和微調腳本中記錄數據集 ID。scripts. |
| 事件應對 | 我們有針對 AI 數據外洩的計畫嗎(例如,模型記住了個人識別資訊)? | 起草並測試一個 AI 數據事件應對手冊,包括模型重新訓練、通知程序和系統審計。 |
結論:以數據治理作為你的競爭護城河
到了2026年,強健的數據治理將不再只是合規成本中心。對於投資在本地 AI 的組織來說,它將成為核心競爭優勢和戰略推手。一個良好治理的數據環境意味著你的 AI 計畫可以更快地推進–而且還很安全。它讓你能夠在不增加風險的前提下利用敏感數據進行創新,向合作夥伴和客戶保證你的道德標準,並打造不僅強大而且公平、問責、值得信賴的 AI 系統。
透過實施這裡概述的框架,你將本地 AI 基礎設施那個主權、安全的基礎,延伸到最重要的部分:數據本身。這不僅讓你的本地 AI 從技術上令人印象深刻的配置,轉變為成熟、具韌性且真正有價值的商業資產,並為未來的法規與道德環境做好充分準備。
為 AI 推行企業級資料治理需要專業知識。LocalArch.ai 幫助組織設計並運行量身打造的資料治理框架,直接整合到本地 AI 基礎設施中。從 PET 選擇到元資料目錄部署,我們確保你的資料管理和模型一樣強大。聯繫我們,從資料開始建立信任。