擴展你的家庭 AI 實驗室:從單 GPU 到多節點分散式推理
從工作站到私有 AI 叢集的演變
整整一年來,我們引導你從建立一個平衡的單GPU系統,到將它虛擬化並建立管理機制。現在,隨著我們進入2026年的後半段,許多資深用戶面臨一個新的挑戰:單一伺服器,不管多強大,都已到達極限。不管你是因為大型模型而遇到GPU記憶體的瓶頸,需要同時服務多個使用者,或者只是想在私人實驗室中突破可能的界限,下一個合理的步驟就是分散式推理。這本進階指南超越了單機方案,探索如何透過連接多個節點來水平擴展你的家庭AI實驗室–將你的硬體集合轉變成一個完整強大的私人叢集,能夠處理那些過去只有雲端供應商才能應對的工作負載。
為什麼要水平擴展?多節點推理的理由
在深入了解「如何做」之前,先理解「為什麼」是很重要的。對進階使用者來說,水平擴展(增加更多機器)與垂直擴展(增加更強大的硬體)各有其獨特的好處:
- 克服記憶體限制:這是最直接的原因。像模型並行這類技術可以把單一的 70B 或 120B+ 參數模型拆分到多張 GPU 的 VRAM 上,即使它們在不同的機器上,也能讓以前「無法運行」的模型變得可用。
- 最大化服務的吞吐量:當你需要處理大量請求時(例如,大型團隊使用的內部聊天機器人),你可以使用流水線並行處理不同節點上的不同請求,或者使用多個模型副本來進行負載均衡。
- 異構硬體的成本效益使用:集群可以讓你整合不同電腦的運算能力 –一台強大的主伺服器搭配 RTX 6000 Ada,一台舊款遊戲 PC 搭配 3090,甚至一台 Intel NUC 搭配 ARC GPU。每台電腦都可以處理適合自己能力的工作負載。
- 高可用性與韌性:透過多節點設置,你可以設計系統讓某個節點出問題時,其他節點可以接手,確保關鍵的 AI 服務仍然可用。
建築藍圖:通往分散實驗室的道路
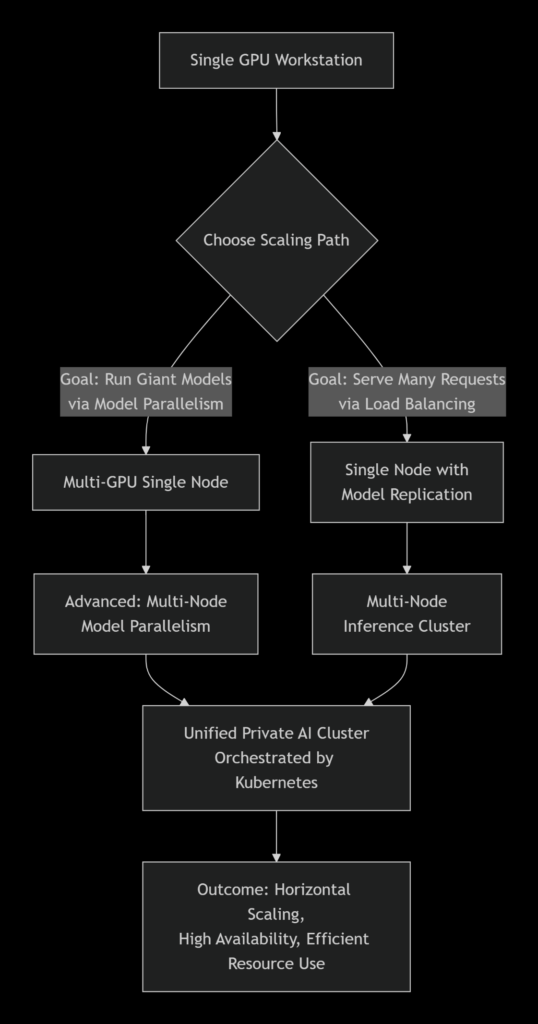
建立叢集沒有單一的「正確」方式。你的方法取決於你的主要目標。下圖說明了從單一 GPU 到分散式推論叢集的主要架構路徑:
途徑1:巨型模型的模型並行
這是給需要運行比任何單一 GPU 記憶體還大的模型的使用者。像 vLLM 裡的 Tensor Parallelism 或 DeepSpeed 這類框架會把模型的層、注意力頭或權重分散到不同的裝置上。GPU 之間的通訊(透過 NVLink 或 PCIe)對效能非常重要。
工具亮點:具備張量並行的 vLLM
vLLM 已經成為高吞吐量服務的黃金標準,現在在分散式推理方面也表現出色。
| # Example: Serving a model across two GPUs on the same machine
python -m vllm.entrypoints.api_server \ –model meta-llama/Llama-3.1-70B-Instruct \ –tensor-parallel-size 2 \ –gpu-memory-utilization 0.9 \ –port 8000
# To extend across nodes, you’d use a –distributed-worker flag # and configure a Ray cluster (vLLM’s distributed backend) |
途徑 2:多節點推理用於服務與負載平衡
這對有很多用戶的應用程式來說非常理想。你可以在不同的機器上運行多個模型副本,然後在它們前面放置一個負載平衡器。
核心堆疊:編排 + 服務 + 路由
- 編排:Kubernetes(K3s/K8s)。輕量級的 K3s 非常適合家用實驗室。它可以管理你的 AI 容器部署、擴縮副本數量,以及處理故障。
- 提供服務:Ollama 或 vLLM 以容器化形式運行。每個都在自己的 Pod 中運行。
- 路由/API 門戶:Traefik 或 Nginx。它位於你的叢集前方,接收所有使用者請求,並將它們均勻分配給健康的模型副本。
實作指南:建立一個雙節點 K3s 叢集
這裡有一份簡化版的指南,教你如何建立一個基本且可運作的叢集。我們假設你有兩台 Linux 機器(node-01 當作伺服器,node-02 當作代理)在同一個網路上。
步驟 1:基礎 – 安裝 K3s
K3s 是一個輕量級、經認證的 Kubernetes 發行版本,非常適合資源有限的環境。
在主節點 (node-01) 上:
| curl -sfL https://get.k3s.io | INSTALL_K3S_EXEC=”–disable traefik –node-taint CriticalAddonsOnly=true:NoExecute” sh –
# Get the node token for joining agents sudo cat /var/lib/rancher/k3s/server/node-token |
在工作節點(node-02):
| curl -sfL https://get.k3s.io | K3S_URL=https://<node-01-ip>:6443 K3S_TOKEN=<token-from-above> sh – |
步驟 2:將你的推理引擎容器化
為你的模型服務創建一個 Dockerfile。這裡有一個 Ollama 的範例:
| DockerFile |
| # Dockerfile.ollama-serve
FROM ollama/ollama:latest RUN ollama pull llama3.1:8b-instruct-q5_k_m EXPOSE 11434 CMD [“ollama”, “serve”] |
在兩個節點上建立並載入映像,或設置一個私人註冊表。
步驟 3:用 Kubernetes 清單部署
建立一個檔案 llama-deployment.yaml。這個檔案告訴 K3s 運行兩個 Ollama pod 的副本並將它們公開。
| yaml |
| apiVersion: apps/v1
kind: Deployment metadata: name: ollama-llama spec: replicas: 2 # Launches two identical pods selector: matchLabels: app: llama-inference template: metadata: labels: app: llama-inference spec: hostname: ollama-pod containers: – name: ollama image: local/ollama-llama:latest ports: – containerPort: 11434 resources: limits: nvidia.com/gpu: 1 # Critical: Requests 1 GPU per pod — apiVersion: v1 kind: Service metadata: name: ollama-service spec: selector: app: llama-inference ports: – protocol: TCP port: 11434 targetPort: 11434 — apiVersion: networking.k8s.io/v1 kind: Ingress metadata: name: ollama-ingress spec: ingressClassName: nginx rules: – http: paths: – path: / pathType: Prefix backend: service: name: ollama-service port: number: 11434 |
部署它:kubectl apply -f llama-deployment.yaml
重要考量與故障排除
擴展會帶來新的複雜性。準備好應對這些常見挑戰吧:
| 挑戰 | 症狀 | 可能原因與解決方法 |
| Pod 裡看不到 GPU | Pod能運行,但用的是CPU,日誌顯示沒用GPU。 | Kubernetes 節點缺少 NVIDIA 裝置插件。在有 GPU 的節點上安裝 nvidia-device-plugin DaemonSet。 |
| 節點之間延遲高 | 跨節點的推理非常慢。 | 網路頻寬/延遲是瓶頸。用有線乙太網(理想是10Gb以上),不要用Wi-Fi。確保模型大小安排得當,讓大部分通訊都在單一節點內進行。 |
| 模型載入失敗 | Pods 啟動時一直當機。 | 容器映像缺少模型文件。確保模型要麼已經包含在映像裡,要麼在啟動時從可靠的網路存儲拉取。 |
| 不平衡負載 | 一個節點很熱,另一個閒置。 | 負載平衡器(Ingress)沒有運作。檢查 Service 選擇器是否符合 Pod 標籤。使用 kubectl get pods -o wide 查看 Pod 運行在哪裡。 |
效能調校小技巧:對於模型平行運算來說,GPU之間的連接非常重要。NVLink(在NVIDIA顯卡上)提供比PCIe高得多的頻寬。在規劃多GPU節點時,優先選擇支援NVLink橋接的顯卡和主機板。
結論:主權 AI 雲已實現
將你的家庭實驗室擴展成多節點分散式推理叢集,是從好奇的使用者進化到自主、私有 AI 雲操作者的最後技術階段。這種能力–曾經只是大型科技公司專屬的領域–現在對於專注的愛好者和小型團隊來說也唾手可得,這多虧了成熟的開源編排工具和越來越容易取得的硬體設備。
從單顆 GPU 到今天這個階段的旅程,完美體現了 LocalArch.ai 的整個理念:利用靈活性、掌控力和深度整合來打造完全貼合你需求的 AI 基礎設施,擺脫外部限制,為未來創新打下基礎。在你規劃暑假後的硬體整合時,不要只想到單台電腦,而是要以節點的概念來思考,打造一個可擴展、面向未來的集群,隨著你的雄心壯志持續成長。
設計和實施一個穩定、高效能的分散式 AI 叢集需要在網路、協調和硬體相容性方面仔細規劃。LocalArch.ai 的基礎設施專家在建構可擴展的本地 AI 系統上擁有豐富經驗,無論是單一伺服器還是多節點叢集。我們歡迎你聯繫我們,共同設計並部署你的私有 AI 雲端。